Полезная экспертиза
Настройка пагинации и rel canonical: руководство для SEO
Как правильно настроить пагинацию и rel canonical. Разбор ошибок, рекомендации Google и Яндекса, рабочие схемы оптимизации страниц без потери трафика.
Многие владельцы сайтов воспринимают пагинацию как чисто техническую деталь интерфейса, не задумываясь о её влиянии на бизнес-показатели. На деле ошибки в разметке страниц приводят к потере трафика, снижению видимости в поиске и росту затрат на рекламу из-за низкой конверсии органики. Понимание механики работы поисковых роботов позволяет превратить служебные страницы из балласта в актив, который приносит клиентов.
Почему пагинация становится скрытой угрозой для SEO
Пагинация возникает там, где контента слишком много для одной страницы. Это могут быть товары в интернет-магазине, статьи в блоге или отзывы пользователей. Для человека это удобно: он листает и находит нужное. Для поискового робота это источник серьезных проблем, если процесс не контролируется.
Логика формирования негативного сценария всегда одинакова. Поисковик видит сотни похожих URL. Он тратит ресурсы на их обход. В результате важные коммерческие страницы остаются без внимания, а сайт начинает ранжироваться по низкочастотным запросам, которые не приносят продаж. Владелец бизнеса видит падение выручки и думает, что проблема в продукте или рынке. На самом деле проблема в архитектуре сайта.
Дублирование контента и размытие релевантности
Страницы пагинации часто содержат повторяющиеся элементы. Шапка, подвал, меню и даже части товарных карточек могут дублироваться из страницы в страницу. Поисковые системы не любят такой контент. Они считают его малоценным.
- Поисковый робот индексирует десятки страниц с одинаковым Title и Description.
- Вес внутренних ссылок распределяется равномерно между всеми страницами серии.
- Основная категория теряет авторитетность, так как ссылки ведут на служебные URL.
Это приводит к тому, что сайт начинает конкурировать сам с собой в поисковой выдаче. Вместо одной сильной страницы, которая могла бы занять топ, в индексе висят десять слабых страниц, которые не показываются выше десятого места.
Проблема не в том, что у вас много страниц. Проблема в том, что поисковая система не понимает, какая из них главная. Без четких сигналов она принимает решения за вас, и эти решения редко выгодны для бизнеса.
Распыление краулингового бюджета
У каждого сайта есть лимит на количество страниц, которые поисковик готов обойти за один визит. Этот лимит называется краулинговым бюджетом. Если робот тратит время на обход бесконечных страниц пагинации, он может не дойти до новых товаров или свежих статей.
В крупных интернет-магазинах это критично. Новые поступления могут индексироваться неделями. Пока они не в индексе, их нельзя купить через поиск. Вы теряете деньги каждый день, пока робот блуждает по старым архивам.
Разница подходов Google и Яндекса к индексации
Оптимизация пагинации осложняется тем, что ведущие поисковые системы смотрят на этот процесс по-разному. То, что работает для Google, может игнорироваться Яндексом, и наоборот. Игнорирование этих различий приводит к частичной видимости сайта.
Google давно отказался от поддержки атрибутов rel="next" и rel="prev". Для него эти теги теперь просто обычный HTML-код, который не несет семантического веса. Алгоритмы Google полагаются на собственные эвристики для определения связи между страницами. Они анализируют структуру ссылок и контент.
Яндекс занимает более консервативную позицию. Хотя официальная поддержка next/prev также ослабла, поисковик по-прежнему внимательно относится к структуре сайта. Ему важно видеть логическую последовательность и понимать, какой контент является основным, а какой вспомогательным.
| Параметр | Яндекс | |
|---|---|---|
| Атрибуты rel="next/prev" | Не учитываются с 2019 года | Могут использоваться как дополнительный сигнал |
| Канонические ссылки | Строгое требование для устранения дублей | Рекомендуются, но требуют уникализации мета-тегов |
| Индексация служебных страниц | Предпочитает скрывать их через noindex | Допускает индексацию при правильной настройке |
| Уникализация контента | Важна, но вторична по отношению к ссылкам | Критически важна для попадания в основной индекс |
Конфликт стратегий оптимизации
Часто веб-разработчики настраивают сайт под одну систему, забывая о другой. Например, закрывают все страницы пагинации от индексации через robots.txt. Для Google это может быть приемлемо, если есть качественные канонические ссылки. Для Яндекса это сигнал о том, что контент недоступен, и он может полностью исключить раздел из поиска.
Другая крайность — оставление всех страниц открытыми без уникализации. Google быстро найдет дубли и понизит сайт в выдаче. Яндекс может долго индексировать мусорный контент, снижая общий траст ресурса.
Необходимость единого стандарта
Эффективная стратегия должна учитывать требования обеих систем. Это достигается не путем компромиссов, а через внедрение технических стандартов, которые понятны всем роботам. Ключевым инструментом здесь становится атрибут rel="canonical".
Правильная настройка канонических ссылок позволяет сказать поисковику: посмотри сюда, здесь основная версия контента. Остальные страницы рассматривай как вспомогательные. Но даже этот инструмент требует осторожности. Ошибка в одном символе URL может привести к тому, что вся серия страниц выпадет из индекса.
Техническая оптимизация — это не разовая акция. Это постоянный процесс контроля над тем, как поисковые системы видят ваш бизнес. Одна ошибка в коде может стоить месяцев потерянного трафика.
Базовые схемы настройки rel canonical
Существует несколько подходов к использованию канонических ссылок в пагинации. Выбор зависит от типа контента и целей сайта. Нет универсального решения, которое работало бы идеально для всех ниш.
Указание канонической ссылки на первую страницу
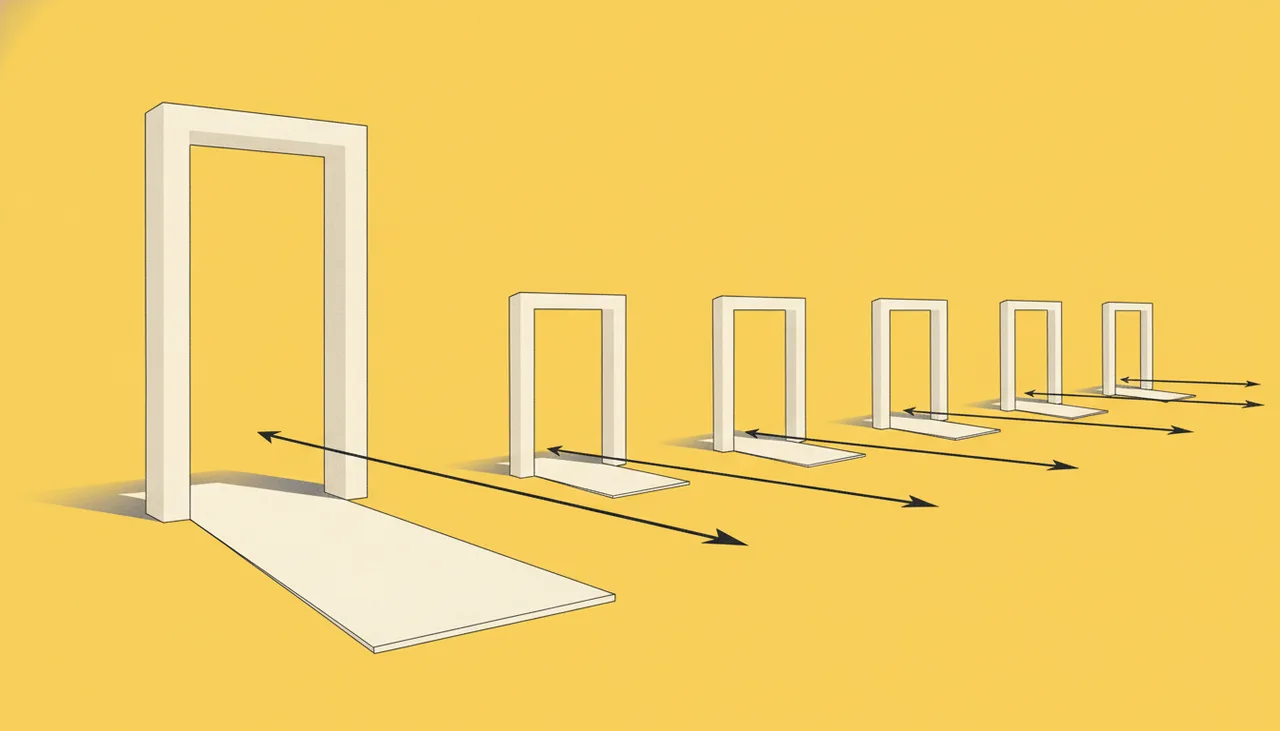
Самый распространенный метод. Все страницы пагинации, начиная со второй, получают ссылку на первую страницу категории. Это сигнализирует поисковику, что именно первая страница является главной точкой входа.
- Плюс метода в простоте реализации.
- Минус в том, что контент со второй и последующих страниц может вообще не индексироваться.
- Подходит для категорий, где важны только топовые товары.
Такой подход эффективен, если пользователи редко углубляются дальше третьей страницы. Если же ваш ассортимент огромен и ценные товары находятся глубоко в списке, этот метод приведет к потере длинного хвоста запросов.
Самореферентные канонические ссылки
Каждая страница пагинации указывает сама на себя как на каноническую. Первая страница ссылается на первую, вторая на вторую и так далее. Это позволяет сохранить каждую страницу в индексе как самостоятельную единицу.
Для работы этой схемы критически важна уникализация мета-тегов. Title и Description каждой страницы должны отличаться. Обычно добавляют номер страницы или уточняющие слова. Без этого поисковик все равно сочтет страницы дублями, несмотря на правильные канонические ссылки.
Применение noindex, follow для скрытия промежуточных страниц
Этот метод часто называют золотой серединой в оптимизации пагинации. Суть подхода заключается в том, чтобы разрешить поисковому роботу переходить по ссылкам на страницах пагинации, но запретить ему индексировать сами эти страницы. Таким образом, вес ссылок передается дальше по цепочке, а мусорный контент не засоряет индекс.
Реализация требует добавления мета-тега robots со значением noindex, follow в код каждой страницы пагинации, кроме первой. Первая страница остается открытой для индексации и служит основной точкой входа для пользователей и роботов.
- Робот видит ссылку на вторую страницу и переходит на нее.
- На второй странице он видит запрет на индексацию, но разрешение следовать по ссылкам.
- Он переходит на третью страницу и так далее, пока не обойдет всю серию.
- В индекс попадает только первая страница, которая аккумулирует весь ссылочный вес.
Этот подход решает проблему распыления краулингового бюджета. Робот не тратит время на анализ дублирующегося контента промежуточных страниц, но при этом находит все товары или статьи, которые на них размещены. Ссылки с этих товаров ведут на их карточки, которые и являются целевыми для индексации.
Метод noindex, follow особенно эффективен для крупных каталогов, где глубина пагинации превышает десять страниц. Он позволяет сохранить логику обхода сайта, не перегружая поисковый индекс техническими дублями.
Оптимизация страницы «Смотреть все» (View All)
Некоторые сайты предлагают пользователям возможность отключить пагинацию и просмотреть весь список товаров или статей на одной длинной странице. Это удобно для пользователя, который хочет быстро оценить ассортимент или воспользоваться поиском по странице браузера.
С точки зрения SEO такая страница может стать идеальным каноническим вариантом. Она содержит полный набор контента категории без разрывов. Если вы реализуете такую функцию, важно правильно настроить канонические ссылки.
Все страницы пагинации должны указывать в атрибуте rel="canonical" ссылку на страницу «Смотреть все». Сама страница «Смотреть все» должна иметь самореферентный каноникал. Это дает поисковику четкий сигнал: вся суть категории сосредоточена здесь.
| Тип страницы | Значение rel="canonical" | Индексация |
|---|---|---|
| Страница 1 | URL страницы "Смотреть все" | Закрыта от индексации (опционально) |
| Страница 2 | URL страницы "Смотреть все" | Закрыта от индексации |
| Страница N | URL страницы "Смотреть все" | Закрыта от индексации |
| Страница "Смотреть все" | Свой собственный URL | Открыта для индексации |
У этого метода есть существенный недостаток. Страница «Смотреть все» может быть очень тяжелой. Загрузка сотен товаров одновременно увеличивает время отклика сервера и объем передаваемых данных. Это негативно сказывается на показателях Core Web Vitals, особенно на мобильных устройствах.
Если страница грузится дольше трех секунд, пользователи начнут уходить, не дождавшись отображения контента. Поисковые системы также учитывают скорость загрузки при ранжировании. Поэтому прежде чем внедрять этот метод, необходимо провести нагрузочное тестирование и оптимизировать вывод данных.
Частые ошибки при работе с каноническими ссылками
Даже опытные разработчики допускают ошибки при настройке пагинации. Часто проблема кроется не в незнании теории, а в невнимательности к деталям реализации. Последствия таких ошибок могут проявиться не сразу, а спустя несколько месяцев, когда трафик начнет стагнировать.
Создание цепочек редиректов и каноникалов
Одна из самых опасных ошибок — формирование цепочки канонических ссылок. Это происходит, когда страница А указывает на страницу Б как на каноническую, а страница Б указывает на страницу В. Поисковые роботы могут запутаться в такой структуре и не понять, какая страница является финальной.
Google рекомендует избегать цепочек. Каноническая ссылка должна вести напрямую на окончательный вариант URL. Если структура сайта меняется и адреса обновляются, необходимо проверить все старые канонические теги и обновить их.
- Проверьте, не ведут ли канонические ссылки на страницы, которые сами имеют канонические ссылки на другие адреса.
- Убедитесь, что конечная страница в цепочке доступна для робота и возвращает код ответа 200.
- Избегайте ситуаций, когда каноническая ссылка ведет на страницу с редиректом.
Цепочки создают лишнюю нагрузку на процесс обхода сайта. Робот вынужден делать дополнительные запросы, чтобы найти истинный канонический адрес. В больших сайтах это может привести к тому, что часть страниц просто не будет обработана за один цикл сканирования.
Блокировка канонической страницы в robots.txt
Парадоксальная, но распространенная ситуация: вебмастер закрывает служебные страницы пагинации в файле robots.txt, но забывает, что одна из них является канонической. Если робот не может получить доступ к канонической странице, он не сможет прочитать тег canonical и понять структуру сайта.
Более того, если каноническая страница закрыта от индексации через robots.txt, поисковик может проигнорировать этот тег и выбрать другую страницу в качестве основной. Это приведет к непредсказуемому поведению в выдаче.
Правило простое: каноническая страница всегда должна быть доступна для сканирования. Если вы хотите скрыть ее от поиска, используйте мета-тег noindex, но не блокируйте доступ роботам через robots.txt. Это позволит поисковику прочитать инструкции и корректно обработать страницу.
Указание нерелевантного или битого URL в атрибуте href
Технические сбои при генерации сайта могут привести к тому, что в атрибуте href тега link rel="canonical" окажется ошибочный адрес. Это может быть ссылка с опечаткой, ссылка на несуществующую страницу или ссылка на совершенно другой раздел сайта.
Поисковая система попытается перейти по этому адресу. Если она получит ошибку 404, тег canonical будет проигнорирован. Если адрес существует, но контент на нем не соответствует текущей странице, поисковик может посчитать это манипуляцией и применить санкции.
Особое внимание стоит уделить параметрам URL. Часто канонические ссылки генерируются автоматически скриптами. Если скрипт не очищает URL от лишних параметров сортировки или фильтров, в индекс могут попасть тысячи вариаций одной и той же страницы. Это размывает релевантность и снижает позиции основного документа.
Проверка корректности реализации пагинации
Настройка технических параметров — это только половина дела. Без регулярного мониторинга вы не узнаете, работают ли внедренные решения так, как задумано. Поисковые системы постоянно обновляют алгоритмы, и то, что работало вчера, сегодня может требовать корректировки.
Анализ через Яндекс.Вебмастер и Google Search Console
Основным инструментом контроля служат панели для вебмастеров от самих поисковых систем. Они предоставляют данные о том, как роботы видят ваш сайт в реальном времени. Игнорирование этих данных равносильно управлению бизнесом с закрытыми глазами.
В Google Search Console обратите внимание на отчет «Страницы». Фильтруйте страницы по статусу «Исключено» и ищите причины, связанные с каноническими ссылками. Если вы видите там важные коммерческие страницы, значит, настройка canonical работает против вас. Проверьте раздел «Проверка URL», чтобы увидеть, какой канонический адрес определяет Google для конкретной страницы.
В Яндекс.Вебмастере ключевым разделом является «Индексирование» -> «Страницы в поиске». Здесь можно отследить, какие страницы пагинации попали в индекс, а какие были исключены. Инструмент «Диагностика» поможет выявить ошибки в разметке и проблемы с доступностью страниц для робота.
- Регулярно проверяйте отчеты на наличие новых ошибок канонизации.
- Сравнивайте количество проиндексированных страниц пагинации с ожидаемым значением.
- Используйте инструмент проверки URL для тестирования отдельных страниц после внесения изменений.
Контроль статуса индексации служебных URL
Важно убедиться, что поисковик правильно интерпретирует ваши инструкции. Если вы выбрали стратегию noindex для промежуточных страниц, проверьте, действительно ли они исчезли из поиска. Используйте оператор site: в строке поиска, чтобы увидеть список проиндексированных страниц конкретного раздела.
Если страницы пагинации все еще присутствуют в выдаче, несмотря на тег noindex, возможно, на них есть внешние ссылки, которые передают вес, или они добавлены в карту сайта sitemap.xml. Уберите служебные URL из sitemap и проверьте внутренние ссылки. Поисковику нужно время на переиндексацию, поэтому изменения могут отобразиться не сразу.
| Проблема | Возможная причина | Решение |
|---|---|---|
| Страницы с noindex в индексе | Наличие в sitemap.xml | Удалить URL из карты сайта |
| Игнорирование canonical | Низкая релевантность канонической страницы | Улучшить контент основной страницы |
| Дубли в выдаче | Отсутствие уникализации Title | Добавить номер страницы в мета-теги |
| Ошибки сканирования | Блокировка в robots.txt | Разрешить доступ к каноническим URL |
Тестирование скорости загрузки и мобильной адаптивности
Техническая SEO-оптимизация неразрывно связана с пользовательским опытом. Пагинация должна быть не только понятной роботам, но и удобной для людей. Особенно это касается мобильных устройств, где экранное пространство ограничено.
Проверьте, насколько удобно переключаться между страницами на смартфоне. Кнопки навигации должны быть достаточно крупными для нажатия пальцем. Расстояние между ссылками должно исключать случайные клики. Если вы используете бесконечную прокрутку, убедитесь, что у пользователя есть возможность вернуться к конкретному товару или статье.
Скорость загрузки также играет критическую роль. Тяжелые скрипты пагинации могут замедлять отображение контента. Используйте инструменты вроде PageSpeed Insights для оценки производительности. Оптимизируйте изображения, минифицируйте код и используйте ленивую загрузку для элементов, находящихся ниже первого экрана.
Хорошая техническая база не гарантирует успеха, но плохая гарантированно приводит к провалу. Пагинация и canonical — это фундамент, на котором строится видимость вашего бизнеса в поиске. Относитесь к нему с тем же вниманием, что и к качеству самого продукта.

