Полезная экспертиза
Группировка запросов в SQL: полное руководство по оператору GROUP BY
Разбираем группировку запросов в SQL. Узнайте, как использовать оператор GROUP BY, агрегатные функции и фильтр HAVING для анализа данных.
Большинство предпринимателей и маркетологов воспринимают хаос в рекламных кампаниях как неизбежное зло. Они видят растущий бюджет и падающую конверсию, но не понимают, где именно теряется эффективность. Проблема редко кроится в самом трафике или качестве сайта. Чаще всего корень зла находится на этапе подготовки данных, когда тысячи поисковых запросов смешиваются в одну кучу без четкой логики.
Почему отсутствие структуры убивает рекламу
Когда вы запускаете контекстную рекламу, алгоритмы площадок получают от вас сигнал в виде ключевых слов. Если эти слова сгруппированы неправильно, система не понимает намерение пользователя. Она показывает объявление о ремонте квартир человеку, который ищет фото дизайна интерьера для вдохновения. Клика нет, денег нет, статистика портится.
Это классический пример того, как техническая ошибка на старте приводит к финансовым потерям в конце. Информация о запросе поступает в систему неверно интерпретированной. Состояние кампании становится нестабильным. Мысли специалиста мечутся между правкой ставок и переписыванием текстов. Решение принимается ошибочное — увеличить бюджет. Действие усугубляет проблему. Результат — слив средств.
Та же логика работает в SEO. Поисковые роботы сканируют ваш сайт и пытаются понять его структуру. Если на одной странице собраны статьи про покупку слона и аренду экскаватора, релевантность страницы падает до нуля. Вы получаете трафик, но не получаете продаж, потому что пользователь не видит решения своей конкретной задачи.
Хаос в данных всегда приводит к хаосу в принятии решений. Чем чище входная информация, тем точнее будет прогноз и выше рентабельность инвестиций.
Механика потери денег на нерелевантном трафике
Рассмотрим ситуацию на примере интернет-магазина бытовой техники. Допустим, вы продаете холодильники. В вашем списке ключей есть фраза ремонт холодильника. Если она находится в той же группе, что и купить холодильник Bosch, происходит подмена смыслов.
- Пользователь ищет мастера по ремонту.
- Он видит ваше объявление о продаже нового устройства.
- Он кликает по ошибке или из любопытства.
- Вы платите за клик, но не получаете лида.
- Показатель отказов растет, качество объявления падает.
Эта цепочка повторяется сотни раз в день. Каждая такая ошибка кажется мелочью. Но в сумме они съедают до 30 процентов рекламного бюджета. Проблема не в том, что люди не хотят покупать. Проблема в том, что вы предлагаете им не то, что они ищут, в данный момент времени.
Что такое группировка запросов на самом деле
Группировка запросов — это процесс распределения ключевых слов по смысловым кластерам. Каждый кластер соответствует отдельной посадочной странице или объявлению. Цель этого процесса — обеспечить максимальное совпадение между намерением пользователя и вашим предложением.
Многие новички думают, что достаточно просто собрать все слова через запятую. Это фатальная ошибка. Поисковые системы давно научились различать нюансы. Запрос дешевый ремонт квартиры и элитный дизайн интерьера требуют разных подходов, разных текстов и разных страниц приземления.
Правильная группировка строится на принципе интента. Интент — это цель, с которой человек вводит запрос в поисковую строку. Он может быть информационным, коммерческим или транзакционным. Смешивание этих типов интентов в одной группе гарантированно снижает эффективность кампании.
Типы намерений пользователей
Чтобы правильно сгруппировать запросы, нужно сначала понять, чего хочет пользователь. Давайте разберем основные типы намерений на примере ниши юридических услуг.
| Тип интента | Пример запроса | Цель пользователя | Подходящий контент |
|---|---|---|---|
| Информационный | как составить договор аренды | Получить знания, инструкцию | Статья, чек-лист, видеоурок |
| Коммерческий | юрист по недвижимости отзывы | Сравнить варианты, выбрать исполнителя | Кейсы, отзывы, список услуг |
| Транзакционный | заказать консультацию юриста москва | Совершить действие, купить услугу | Форма заявки, контакты, цена |
Если вы попытаетесь продвигать страницу с формой заказа по запросу как составить договор, вы потерпите неудачу. Человек еще не готов покупать, он только учится. Ему нужна польза, а не продажа. И наоборот, если вы дадите ему длинную статью вместо кнопки заказать, он уйдет к конкурентам, которые предложили быстрое решение.
Как ошибки в структуре влияют на психологию бизнеса
Влияние плохой группировки выходит далеко за рамки цифр в рекламном кабинете. Оно проникает в состояние владельца бизнеса. Когда вы видите, что деньги уходят, а результата нет, возникает тревога. Тревога перерастает в стресс. Стress ведет к выгоранию.
Часто предприниматели начинают винить себя или свою команду. Возникают мысли о том, что продукт никому не нужен. Эти мысли ложные. Продукт может быть идеальным. Просто канал коммуникации с клиентом засорен мусором. Вы кричите в толпу, но не обращаетесь к конкретному человеку.
Проблемы в бизнесе — это часто симптомы системных ошибок в обработке информации. Исправив структуру данных, вы исправляете и финансовое состояние, и свое эмоциональное равновесие.
От технического долга к личному выгоранию
Давайте проследим эту связь на реальном примере. Владелец небольшого сервиса по уборке квартир запустил рекламу. Он собрал тысячу запросов и загрузил их в одну кампанию. Через неделю бюджет был исчерпан, заявок почти не было.
Вместо того чтобы сесть и разобрать запросы по смыслу, он начал нервничать. Он стал менять картинки в объявлениях каждый день. Потом решил снизить цены. Потом уволил менеджера, который якобы плохо обрабатывал звонки. Ни одно из этих действий не решило главную проблему — нерелевантный трафик.
Через месяц такой работы владелец оказался в состоянии апатии. Он считал, что рынок перегрет и конкуренция слишком высока. На самом деле он просто не провел базовую работу по сегментации аудитории. Его болезнь была не в отсутствии клиентов, а в неспособности их услышать из-за шума в данных.
Такие ситуации встречаются повсеместно. Люди борются с симптомами, игнорируя причину. Они меняют дизайнеров, копирайтеров, таргетологов, но оставляют неизменной фундаментальную ошибку в структуре запросов. Пока вы не наведете порядок в базе ключевых слов, любые другие улучшения будут носить временный характер.
Принципы правильной кластеризации
Существует несколько подходов к группировке запросов. Выбор зависит от размера проекта, бюджета и целей. Однако есть универсальные правила, которые работают всегда. Первое правило — один интент, одна группа. Второе правило — релевантность заголовка запросу. Третье правило — учет частотности и конкуренции.
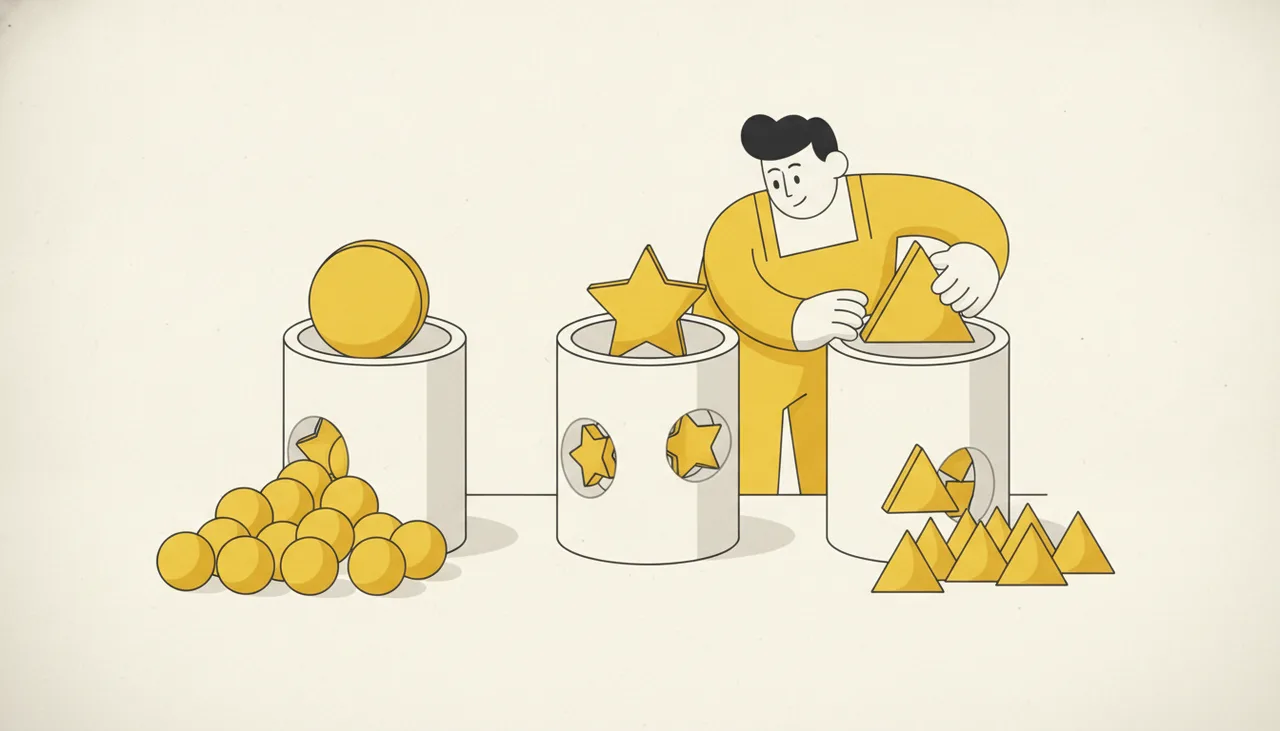
Нельзя группировать запросы только по наличию общих слов. Запросы купить слона и купить игрушечного слона имеют общее слово, но абсолютно разную аудиторию и цену продукта. Смешивать их нельзя. Алгоритмы поисковиков учитывают семантику, а не просто лексическое совпадение.
Ошибки ручного распределения
При ручной группировке специалисты часто допускают типичные ошибки. Они пытаются охватить слишком широкие темы в одном кластере. Или наоборот, дробят запросы слишком мелко, создавая сотни групп с одним ключом в каждой. Оба подхода вредны.
- Слишком широкие группы размывают фокус объявления.
- Слишком узкие группы усложняют управление кампанией.
- Игнорирование минус-слов приводит к пересечению аудиторий.
- Отсутствие учета геозависимости искажает статистику.
Баланс достигается опытом и анализом выдачи. Перед тем как создать группу, всегда смотрите на первые десять результатов поиска. Если там представлены разные типы сайтов — например, википедия рядом с интернет-магазином — значит, запрос имеет смешанный интент. Такой запрос лучше выделить отдельно или использовать с осторожностью.
Базовый синтаксис и принцип работы оператора
Понимание того, как работает оператор GROUP BY, требует перехода от абстрактных маркетинговых метафор к конкретной технической логике. В контексте баз данных этот оператор выполняет ту же функцию, что и кластеризация в рекламе: он собирает разрозненные строки таблицы в упорядоченные группы на основе заданных критериев.
Когда вы пишете запрос к базе данных, система не просто выдает вам список всех записей. Она может предварительно обработать эти данные, объединив их по определенному признаку. Это позволяет перейти от анализа отдельных транзакций к анализу общих тенденций. Вместо того чтобы смотреть на каждую покупку холодильника по отдельности, вы видите общую сумму продаж по каждой модели.
GROUP BY — это мост между сырыми данными и аналитическими выводами. Без него вы видите лес из отдельных деревьев, с ним — карту всего леса.
Как составить простой запрос с группировкой
Синтаксис запроса с группировкой имеет строгую структуру. Нарушение порядка элементов приводит к ошибке выполнения. Базовая конструкция выглядит следующим образом: сначала указывается, какие данные выбрать, затем откуда их взять, и только потом — как их сгруппировать.
Рассмотрим пример. Допустим, у нас есть таблица sales с полями product_name, category и amount. Мы хотим узнать, сколько товаров продано в каждой категории. Запрос будет выглядеть так:
- SELECT category, SUM(amount) FROM sales
- GROUP BY category;
В этом примере ключевое слово GROUP BY указывает базе данных, что все строки с одинаковым значением в поле category должны быть объединены. Функция SUM затем подсчитывает сумму значений amount для каждой такой группы. Результатом будет таблица, где каждая строка представляет собой уникальную категорию и общую сумму продаж по ней.
Важно помнить, что в части SELECT можно указывать только те столбцы, которые участвуют в группировке, или агрегатные функции. Если вы попытаетесь вывести product_name без добавления его в GROUP BY, база данных не сможет определить, какое именно название товара показать для всей группы категорий.
Группировка по одному и нескольким столбцам
Часто одного критерия для анализа недостаточно. Бизнесу нужно видеть картину в разрезе нескольких параметров одновременно. Например, нам важно знать не просто общие продажи по категориям, но и распределение этих продаж по месяцам или регионам.
Группировка по нескольким столбцам создает более детализированные кластеры. Система ищет уникальные комбинации значений во всех указанных полях. Если в первой колонке значение повторяется, но во второй оно другое, запись попадет в новую группу.
| Уровень группировки | Поля в GROUP BY | Результат | Пример использования |
|---|---|---|---|
| Одиночный | category | Общие итоги по категориям | Анализ популярности разделов сайта |
| Двойной | category, month | Продажи по категориям в разрезе месяцев | Выявление сезонности спроса |
| Тройной | category, month, city | Детальная статистика по городам и времени | Локализация рекламных бюджетов |
При использовании множественной группировки порядок столбцов в операторе GROUP BY обычно не влияет на конечный результат, но может влиять на скорость выполнения запроса, если в базе данных существуют специфические индексы. Главное правило здесь — чем больше столбцов вы добавляете, тем мельче становятся группы и тем меньше строк попадает в каждую из них.
Это напрямую коррелирует с принципом релевантности в рекламе. Чем точнее вы сегментируете аудиторию, тем меньше людей попадает в каждый сегмент, но тем выше вероятность конверсии внутри этого сегмента. В базах данных это выражается в более точных агрегированных показателях для узких ниш.
Использование агрегатных функций в запросах
Сама по себе группировка без вычислений малополезна. Смысл объединения строк заключается в том, чтобы применить к ним математические или статистические операции. Для этого в SQL существуют агрегатные функции. Они принимают набор значений из группы и возвращают одно итоговое значение.
Агрегатные функции игнорируют пустые значения NULL, что делает их безопасными для использования в реальных данных, где часто встречаются пропуски. Однако они требуют понимания того, какой именно показатель важен для принятия решения в данный момент.
COUNT, SUM, AVG для подсчета данных
Три самые распространенные функции — это подсчет количества, суммы и среднего значения. Каждая из них отвечает на свой тип бизнес-вопроса.
Функция COUNT используется, когда нужно понять объем явления. Сколько всего заказов было сделано? Сколько уникальных пользователей посетило страницу? В маркетинге это аналог охвата или количества кликов. Важно различать COUNT(*) и COUNT(column). Первая считает все строки, включая пустые, вторая — только заполненные ячейки в конкретном столбце.
Функция SUM дает понимание общего финансового результата. Общая выручка, общий расход бюджета, общее время на сайте. Это абсолютный показатель, который растет вместе с масштабом бизнеса. Но сам по себе он не говорит об эффективности.
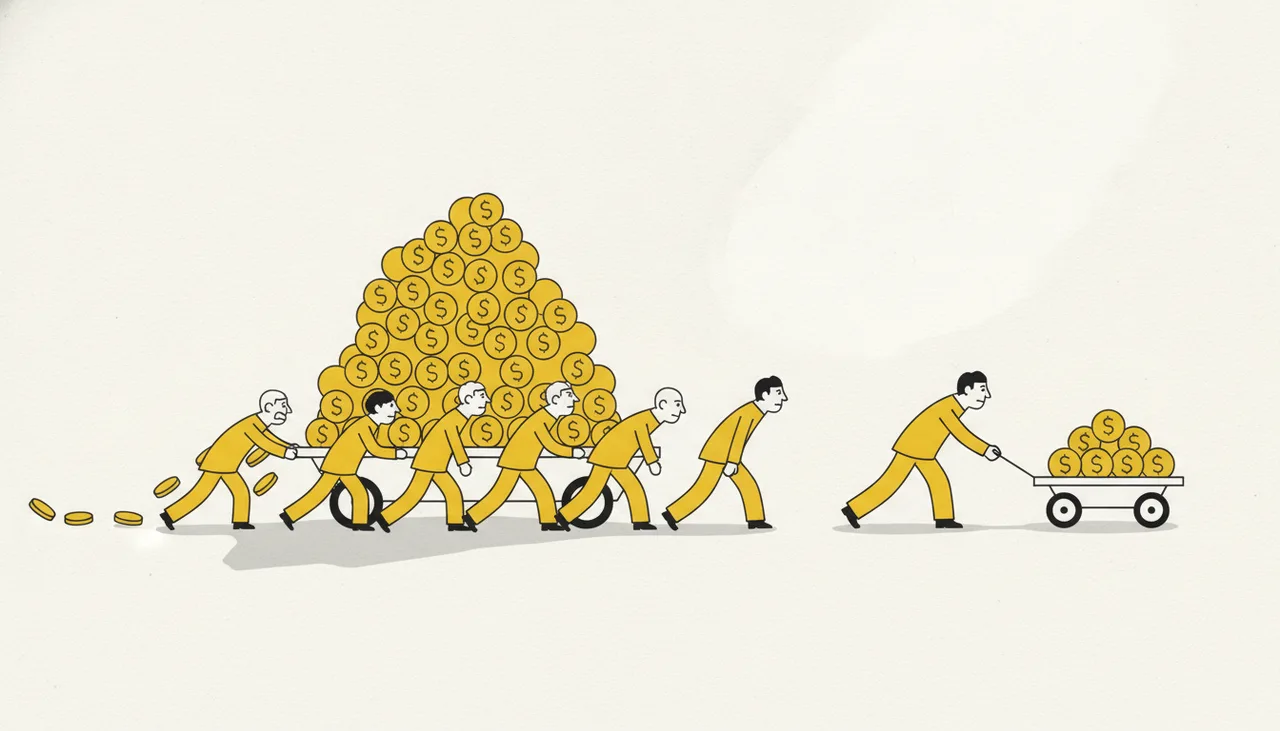
Большие цифры суммы могут скрывать низкую эффективность. Только соотношение суммы к количеству (среднее значение) показывает реальную картину.
Функция AVG вычисляет среднее арифметическое. Это ключевой показатель для оценки качества. Средний чек, средняя стоимость лида, среднее время сессии. Именно средние значения позволяют сравнивать разные периоды или разные каналы трафика, нивелируя разницу в объемах.
- COUNT помогает оценить масштаб.
- SUM помогает оценить общий ресурс.
- AVG помогает оценить качество и эффективность.
При использовании этих функций вместе с GROUP BY вы получаете мощнейший инструмент аналитики. Вы можете увидеть, что в одной категории товаров средний чек высокий, но количество заказов маленькое, а в другой — наоборот. Это знание позволяет принимать взвешенные решения о перераспределении ресурсов.
MIN и MAX для поиска крайних значений
Помимо средних показателей, бизнесу часто важно понимать границы возможных значений. Функции MIN и MAX позволяют найти минимальное и максимальное значение в группе. Это критически важно для выявления аномалий и определения ценового диапазона.
В контексте интернет-рекламы это может быть минимальная стоимость клика по ключевому слову или максимальная конверсия среди всех регионов. В базах данных с помощью этих функций можно быстро определить дату первой и последней покупки клиента, что помогает рассчитывать жизненный цикл пользователя.
- MIN показывает нижнюю границу эффективности или стоимости.
- MAX выявляет пиковые нагрузки или рекордные показатели.
- Разница между MAX и MIN дает понимание разброса данных.
Использование этих функций вместе с GROUP BY позволяет сегментировать аудиторию не только по средним значениям, но и по экстремальным показателям. Вы можете выделить группу самых лояльных клиентов по максимальной сумме заказа или найти проблемные регионы с минимальной активностью.
Фильтрация результатов: разница между WHERE и HAVING
Один из самых сложных моментов для новичков в SQL — понимание того, как правильно фильтровать данные при использовании группировки. Здесь в игру вступают два оператора: WHERE и HAVING. Они выполняют похожую функцию отсечения лишнего, но работают на разных этапах выполнения запроса.
Неправильное использование этих операторов приводит к тому, что запрос либо выдает ошибку, либо возвращает неверные данные. Понимание их различия — это маркер перехода от любителя к профессионалу в работе с данными.
Когда применять WHERE до группировки
Оператор WHERE применяется к исходным строкам таблицы до того, как начнется процесс группировки. Он отвечает на вопрос: какие данные вообще должны участвовать в расчете? Если вам нужно проанализировать продажи только за последний месяц, вы используете WHERE для отсечения старых записей.
Это работает как предварительная очистка трафика в рекламе. Вы заранее исключаете нецелевые площадки или устройства, чтобы не тратить ресурсы на их обработку. WHERE уменьшает объем данных, с которыми будет работать агрегатная функция, что значительно ускоряет выполнение запроса.
WHERE фильтрует сырые данные. Если условие не выполнено, строка даже не попадет в группу для подсчета.
Как отфильтровать группы после вычислений через HAVING
Оператор HAVING применяется уже после того, как группы сформированы и агрегатные функции посчитали результаты. Он отвечает на вопрос: какие итоги нас интересуют? Если вы хотите увидеть только те категории товаров, где сумма продаж превысила миллион рублей, вы используете HAVING.
В маркетинге это аналог анализа эффективности после сбора статистики. Вы не можете отфильтровать кампании по средней стоимости лида до того, как эта стоимость будет рассчитана. Сначала собираются все данные, потом считается метрика, и только потом происходит отбор лучших performers.
| Характеристика | WHERE | HAVING |
|---|---|---|
| Этап применения | До группировки | После группировки |
| Объект фильтрации | Отдельные строки таблицыСгруппированные результаты | |
| Работа с агрегатами | Не поддерживает (SUM, COUNT и др.) | Поддерживает агрегатные функции |
| Влияние на скорость | Ускоряет запрос, уменьшая объем данных | Применяется к уже обработанным данным |
Частая ошибка — попытка использовать WHERE с агрегатной функцией. База данных просто не поймет этого условия, так как на этапе фильтрации строк итоговые суммы еще не существуют. Правильная последовательность действий всегда такова: отобрать нужные строки через WHERE, сгруппировать их через GROUP BY, посчитать итоги и отфильтровать группы через HAVING.
Типичные ошибки при работе с GROUP BY
Даже понимая теорию, разработчики и аналитики часто допускают практические ошибки. Эти ошибки могут приводить к тихим сбоям, когда запрос выполняется, но данные искажаются, или к явным ошибкам выполнения.
Первая распространенная ошибка — включение в SELECT столбцов, которые не указаны в GROUP BY и не обернуты в агрегатную функцию. В некоторых версиях SQL это допускается, но результат будет непредсказуемым: система вернет значение из первой попавшейся строки группы, что может ввести в заблуждение.
Вторая ошибка — игнорирование влияния NULL-значений. При группировке все пустые значения объединяются в одну отдельную группу. Если вы не учитываете этот факт, ваша статистика по категориям может оказаться смещенной. Например, товары без указанной категории соберутся в один большой кластер NULL, который исказит общую картину распределения.
- Забывание добавить столбец из SELECT в GROUP BY.
- Попытка использовать агрегатные функции в условии WHERE.
- Неучет регистрозависимости в текстовых полях при группировке.
- Группировка по полям с низкой кардинальностью, что создает слишком крупные и бесполезные группы.
Третья ошибка связана с производительностью. Группировка по текстовым полям большой длины или по полям без индексов может сильно замедлить работу базы данных. Важно оптимизировать структуру таблиц и использовать индексы для тех полей, по которым часто происходит группировка.
Работа с данными требует такой же дисциплины, как и управление рекламным бюджетом. Хаос в запросах приводит к хаосу в выводах. Только четкая структура, понимание логики работы инструментов и внимательность к деталям позволяют превращать сырую информацию в надежный фундамент для бизнес-решений.

Данные не врут, но они могут молчать, если вы задаете им неправильные вопросы. Группировка — это искусство задавать верные вопросы.

